996개 스타를 받은 soynlp, 한국어 새 단어는 어떻게 찾을까요?
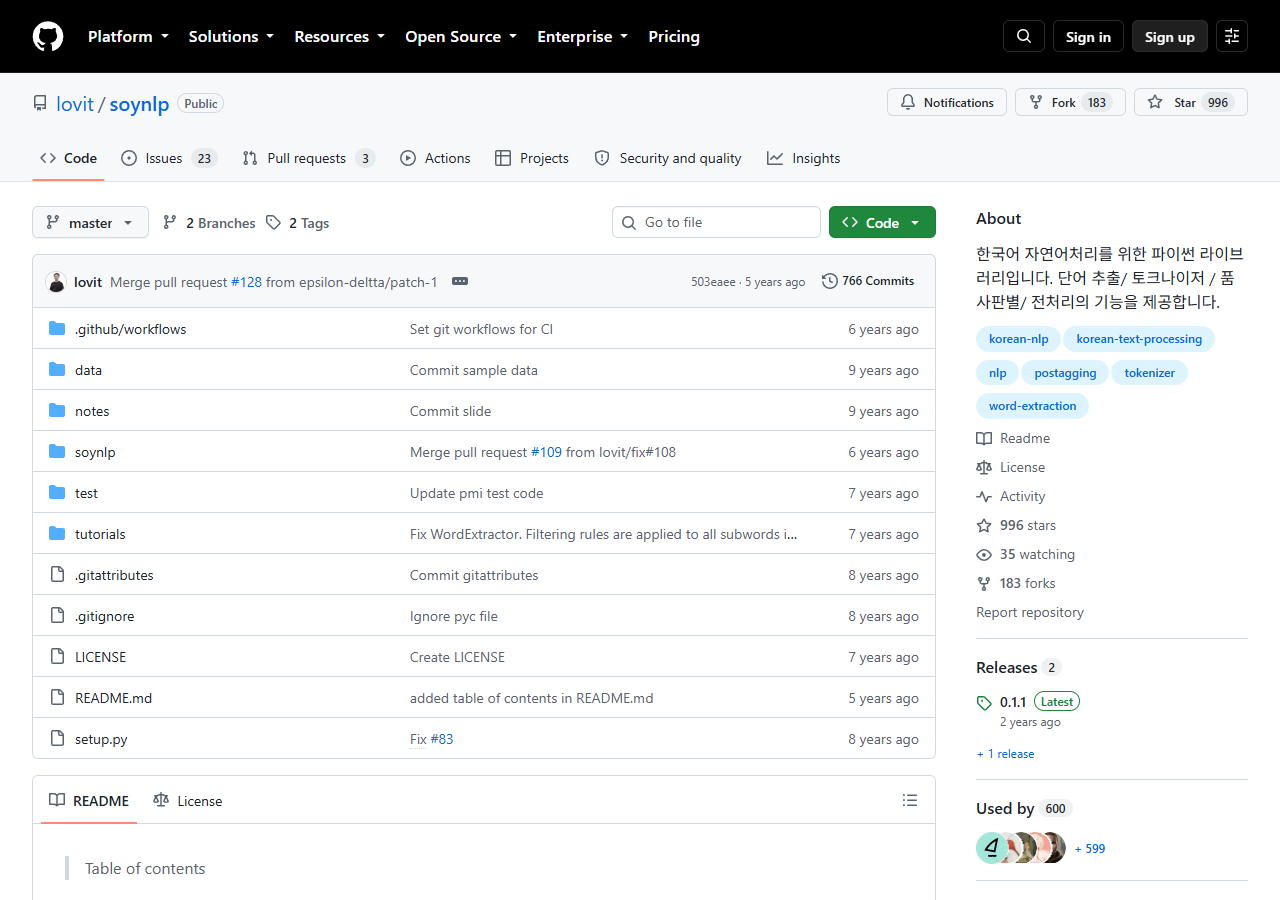
한국어 댓글이나 뉴스에는 사전에 없는 신조어와 이름이 금세 등장합니다. 형태소 분석기가 낯선 표현을 쪼개거나 놓치면, 직접 단어를 모아 사전을 보완해야 할지 막막해지죠. 이런 문제를 말뭉치 통계로 풀어보려는 개발자에게 soynlp는 반가운 도구입니다. lovit/soynlp 저장소는 996개의 스타를 받았고, 어제 늘어난 스타 수는 집계가 제공되지 않아 숫자로 덧붙이지 않겠습니다.
① 한국어 말뭉치에서 새 단어를 찾고 싶을 때, soynlp
한국어 댓글이나 뉴스에는 사전에 없는 신조어와 이름이 금세 등장합니다. 형태소 분석기가 낯선 표현을 쪼개거나 놓치면, 직접 단어를 모아 사전을 보완해야 할지 막막해지죠. 이런 문제를 말뭉치 통계로 풀어보려는 개발자에게 soynlp는 반가운 도구입니다. lovit/soynlp 저장소는 996개의 스타를 받았고, 어제 늘어난 스타 수는 집계가 제공되지 않아 숫자로 덧붙이지 않겠습니다.
soynlp는 한국어 자연어처리를 위한 Python 라이브러리로, 데이터에 나타난 단어 추출과 토큰화, 품사 판별, 전처리를 지원합니다. 사전이나 학습 데이터에만 기대지 않고 말뭉치에서 단어의 경계를 찾는 비지도 학습 접근법을 지향합니다. README는 `WordExtractor`가 단어 경계 점수를 학습하고, 명사 추출기와 여러 토크나이저도 제공한다고 설명합니다. 코드를 열어보니 `soynlp/noun/`, `soynlp/tokenizer/`, `soynlp/postagger/`처럼 기능이 나뉘어 있어 필요한 영역을 살펴보기 좋습니다.
특히 README에서 영화 댓글이나 하루치 뉴스처럼 비슷한 주제의 문서들을 모아 학습하라고 짚어주는 점이 친절합니다. 서로 성격이 다른 문서를 한꺼번에 넣으면 단어가 잘 추출되지 않을 수 있다는 실무적인 안내죠. `tutorials/`에는 명사 추출, 토큰화, 품사 태깅 예제가 있고, 테스트와 CI도 저장소에 갖춰져 있습니다. 기능을 소개하는 데 그치지 않고 직접 따라가 볼 자료까지 정리해 둔 배려가 느껴집니다.
이만한 한국어 도구를 시간 들여 만들고, 코드와 설명을 함께 공개해주신 개발자께 진심으로 감사한 마음이 듭니다. 새 단어를 놓치지 않으려 고군분투하는 개발자에게 든든한 출발점이 될 수 있습니다.
📌 먼저 보는 핵심 답변 (30초 요약)
- **총점 4.8점, 강력 추천해요. soynlp는 말뭉치 기반 한국어 단어 추출과 토큰화, 품사 판별을 제공하는 Python 라이브러리예요.**: 총점 4.8점, 강력 추천해요. soynlp는 말뭉치 기반 한국어 단어 추출과 토큰화, 품사 판별을 제공하는 Python 라이브러리예요.
- **기능별 코드 구조와 README·튜토리얼이 잘 갖춰져 있고, 확인한 8개 기능 설명이 코드 근거와 맞아요.**: 기능별 코드 구조와 README·튜토리얼이 잘 갖춰져 있고, 확인한 8개 기능 설명이 코드 근거와 맞아요.
- **회사 도입 전에는 NOASSERTION으로 표시된 라이선스 판정을 확인하고, 주제가 비슷한 말뭉치로 학습하는 편이 좋아요.**: 회사 도입 전에는 NOASSERTION으로 표시된 라이선스 판정을 확인하고, 주제가 비슷한 말뭉치로 학습하는 편이 좋아요.
별점 안내: 이 글의 별점은 응원 점수입니다. 근거 기본 점수에 1점을 더하고 최소 3점을 적용합니다. README와 코드가 다르면 설명 일치도는 최대 4점입니다.
② 기능별 폴더와 친절한 튜토리얼, 시작 전에 볼 것들
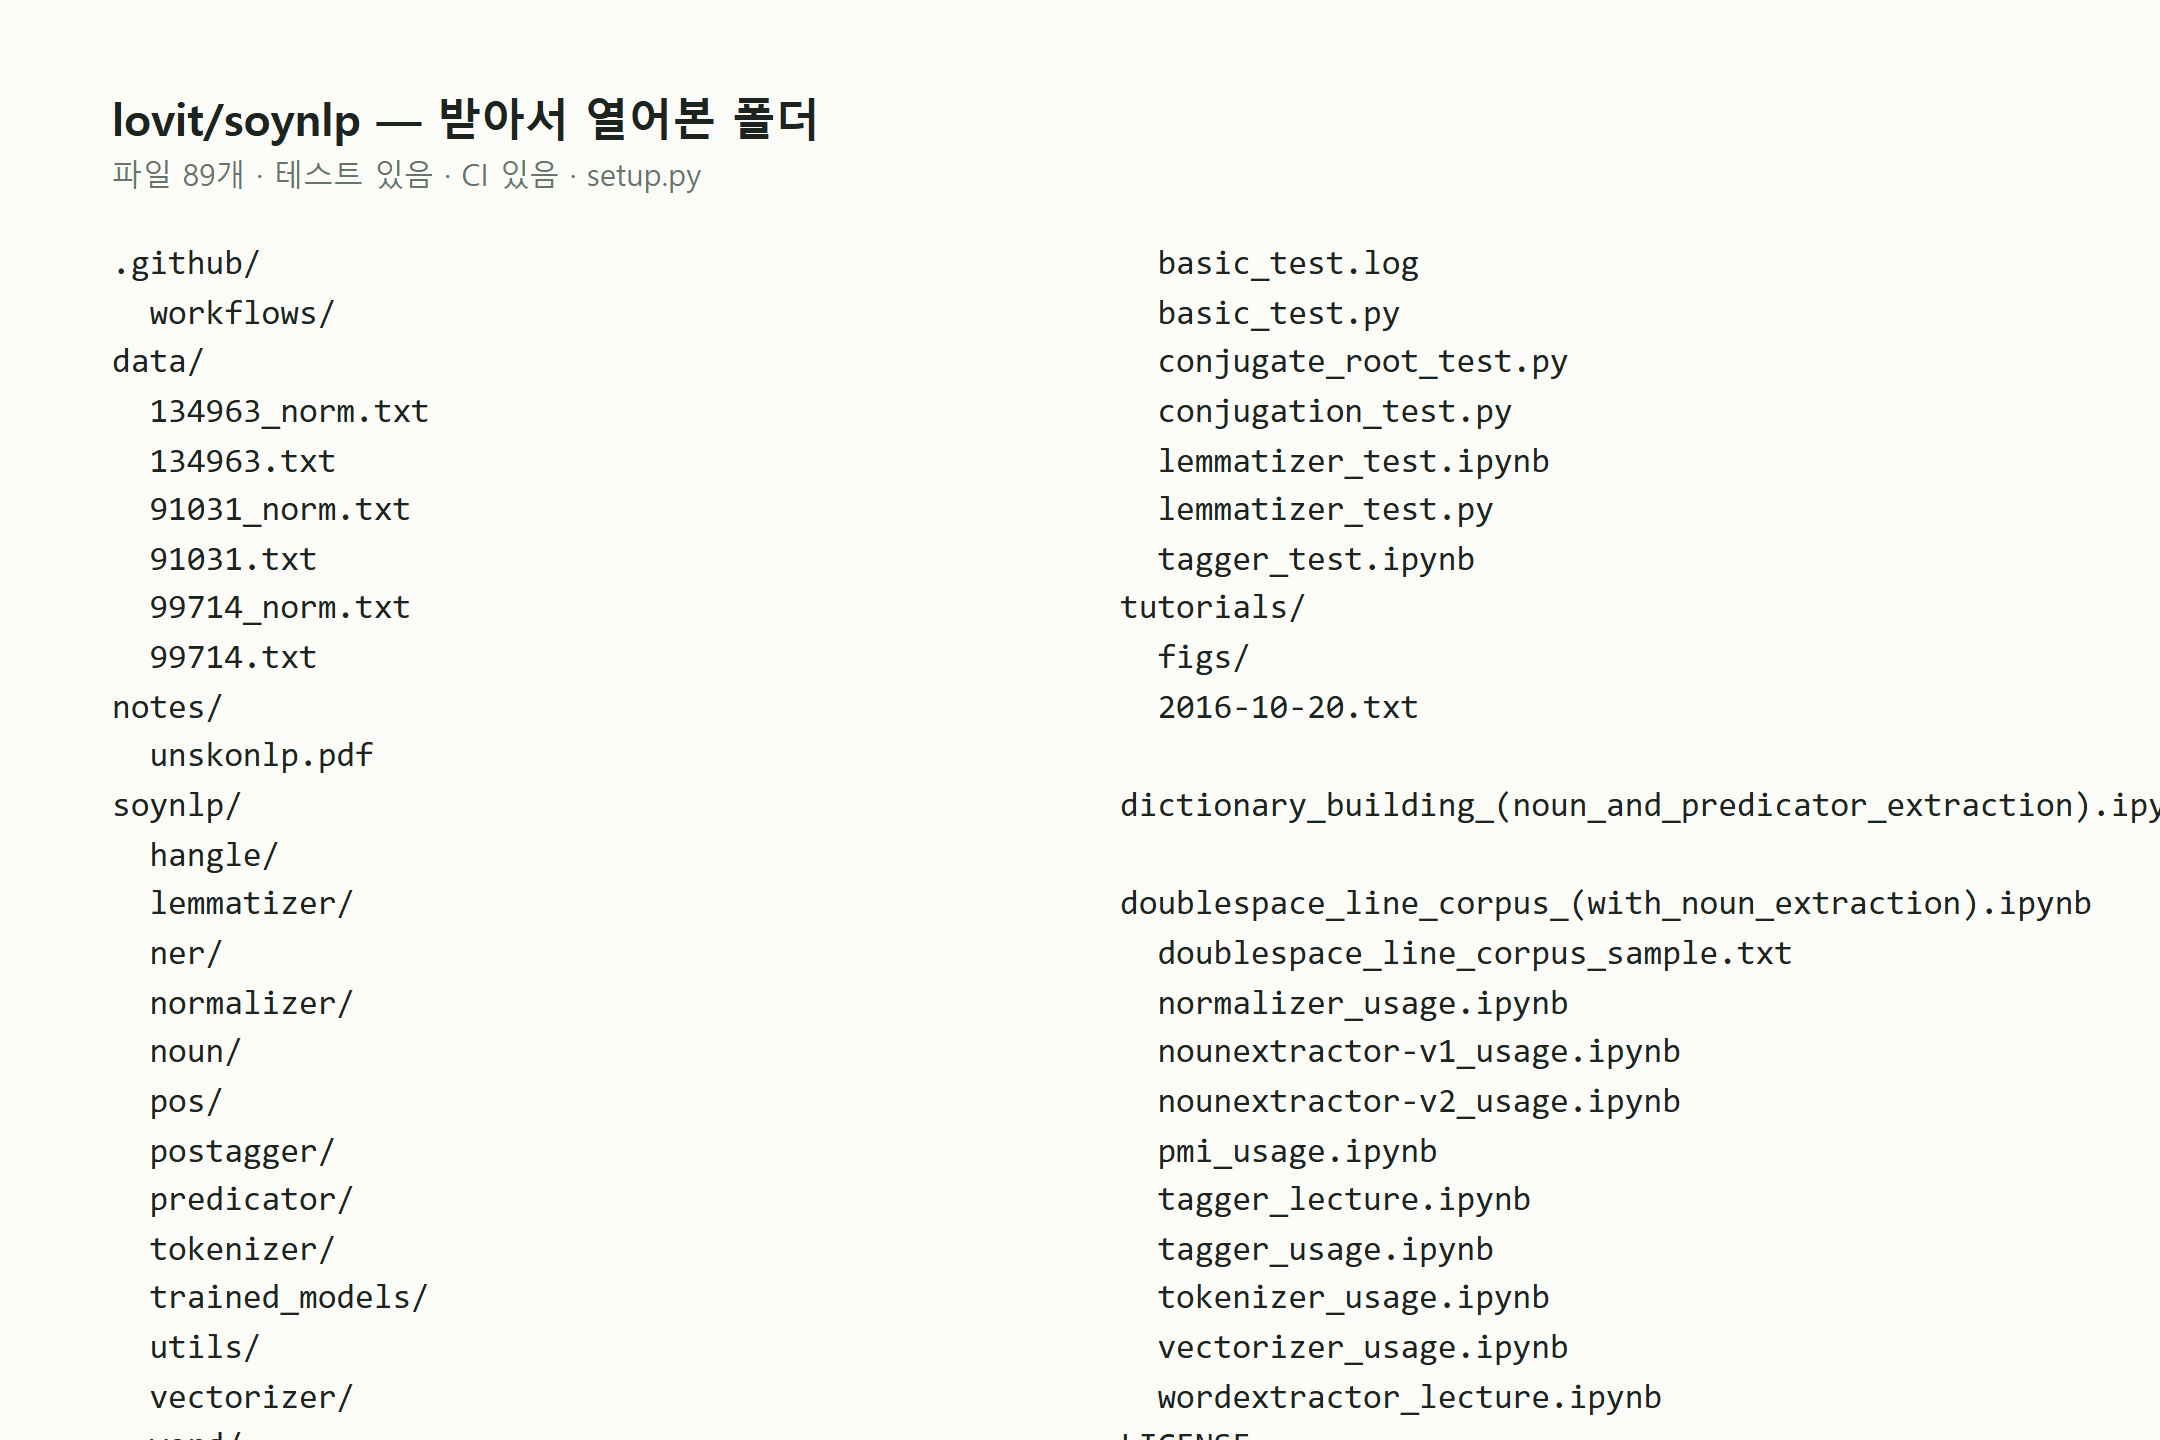
폴더 이름만 봐도 soynlp가 어떤 문제를 풀어주는지 한눈에 들어옵니다. `soynlp/noun`, `tokenizer`, `postagger`, `normalizer`, `vectorizer`가 기능별로 나뉘어 있어 필요한 부분부터 살펴보기 좋습니다. `soynlp/__init__.py`와 `setup.py`가 있고, 명사 추출과 토크나이징부터 품사 판별, 전처리, 벡터화까지 한 저장소 안에서 이어지는 구성이 든든합니다. 기능을 한데 뭉치지 않고 각 디렉터리로 정리한 점에서, 오래 다듬어 온 설계의 손길이 느껴집니다.
문서가 코드와 나란히 놓인 점도 반갑습니다. `test/`에는 `basic_test.py`, 활용형 관련 테스트와 노트북이 있고, `tutorials/`에는 명사 추출기 버전별 사용법부터 토크나이저, 정규화, 벡터라이저 예제까지 마련돼 있습니다. README의 기능 안내를 읽은 뒤 해당 노트북과 폴더를 찾아가며 구조를 익힐 수 있습니다. 이렇게 학습 자료까지 공개해 주신 덕분에 처음 접하는 개발자도 방향을 잡기 쉽겠습니다.
시작 전에 필요한 정보는 README 기준으로 아래처럼 정리할 수 있습니다.
text
설치 명령(README): pip install soynlp
Python(README): 3.5+ 지원
의존성(README): numpy >= 1.12.1, psutil >= 5.0.1, scipy >= 1.1.0, scikit-learn >= 0.20.0
첫 줄만 실제 설치 명령이고, 나머지는 README에 적힌 준비 정보입니다. README에서는 API 키가 필요하다고 안내하지 않습니다. 설치 전 Python 버전과 의존성을 확인하면 준비에 도움이 됩니다. 이런 안내를 README 앞부분에 모아 둔 것도 고마운 부분입니다. 만든 분이 기능뿐 아니라 다음 사람이 배울 경로까지 세심하게 챙겨 주셨다는 인상을 받습니다.
③ README의 약속을 코드에서 확인하고, 기존 방식과 나란히 보기
README의 설명만 나열한 게 아니라 코드 위치까지 대조해보니, 여덟 가지 기능이 저마다 분명한 역할을 갖고 있습니다. 명사 추출기는 `soynlp/noun/__init__.py`에서 `LRNounExtractor`로 확인됩니다. 문서 집합의 통계를 바탕으로 새 명사를 찾는 설계가 반갑습니다. `soynlp/noun/_noun_ver2.py`의 v2는 복합명사 구성 정보인 `_compounds_components`와 어절의 L-R 구조를 제공해, 추출 결과를 더 자세히 살펴볼 수 있게 합니다.
단어 경계를 학습하는 `WordExtractor`는 `soynlp/noun/_noun_ver1.py`에서 확인됩니다. `soynlp/tokenizer/__init__.py`의 `LTokenizer`는 단어 점수로 어절을 L과 R로 나누고, `soynlp/noun/_noun_ver2.py`의 `MaxScoreTokenizer`는 점수를 활용해 문장을 단어열로 분할합니다. 같은 `soynlp/tokenizer/__init__.py`의 `RegexTokenizer`는 정규식 규칙으로 나눕니다. 말뭉치 통계와 규칙 기반 방식을 함께 제공하는 점이 실용적입니다. `setup.py`에는 사전 기반 품사 판별에 쓰이는 `Dictionary`가, `soynlp/vectorizer/__init__.py`에는 문서를 희소 행렬로 바꾸는 `BaseVectorizer`가 있습니다. 빈도 기준까지 다루도록 구성한 점도 꼼꼼합니다.
| 구분 | 이 저장소 | 기존/대안 방식 | 이런 분께 추천 |
|---|---|---|---|
| 새 단어·명사 | 말뭉치 통계로 학습하는 `WordExtractor`, 명사 추출기 | 사전·규칙 또는 라벨이 있는 지도학습 | 도메인 고유어와 미등록 단어를 찾고 싶은 분 |
| 토큰화·품사 | 점수 기반 L·R 분리와 MaxScore, 정규식 토크나이저, 사전 기반 판별 | 규칙·사전 중심 분석기나 학습 데이터 기반 모델 | 데이터와 목적에 맞춰 방식을 고르고 싶은 분 |
| 문서 벡터화 | 토크나이저를 활용해 희소 행렬과 빈도 기준 구성 | 별도 전처리와 벡터화 도구 조합 | 한국어 문서 분석 흐름을 한 라이브러리에서 구성하려는 분 |
README의 튜토리얼과 코드 구조가 서로 이어져 있어 따라가기도 좋습니다. 만든 분이 이런 도구와 설명을 공개해주신 덕분에, 말뭉치 기반 접근을 직접 살펴볼 수 있다는 점이 고맙습니다.
④ 설명 일치도부터 라이선스까지, 별점과 총평
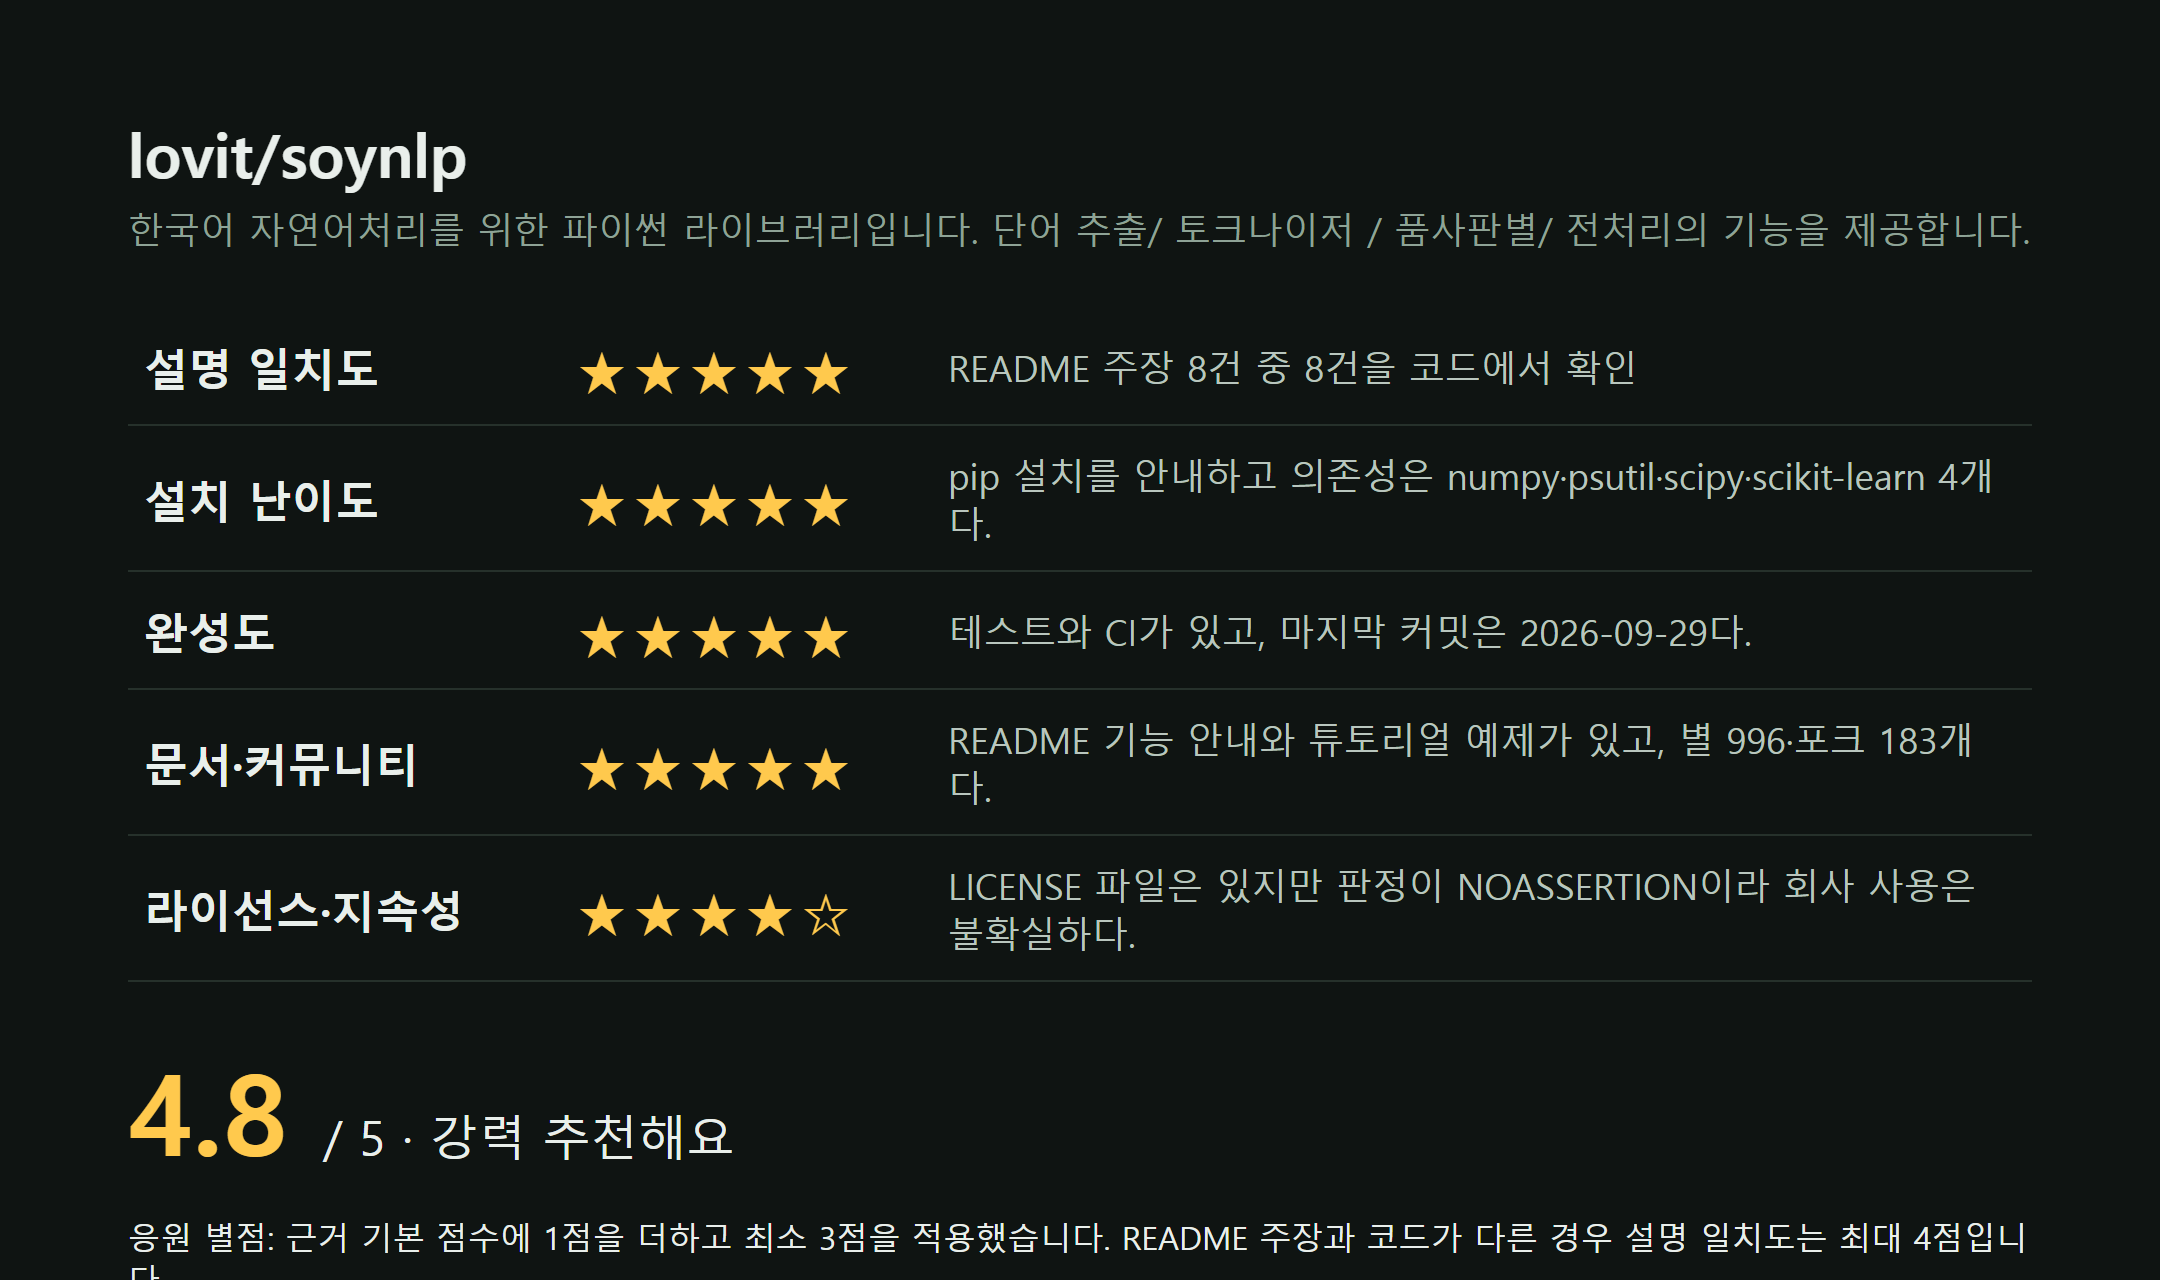
soynlp에서 가장 인상적인 점은 README의 설명이 코드와 잘 맞는다는 점입니다. 기능을 폭넓게 소개하는 데서 그치지 않고, 명사 추출과 새 단어 점수 계산, 토크나이저, 벡터화까지 실제 구현으로 이어집니다. 문서와 코드를 차근차근 대조해볼수록, 오랫동안 다듬어 공개해주신 분들의 정성이 느껴집니다.
- **설명 일치도 ★★★★★** — README의 기능 설명 8건을 코드에서 모두 확인했어요. `soynlp/noun/`의 명사 추출기와 `soynlp/tokenizer/`의 토크나이저처럼 안내와 구현이 구체적으로 이어집니다.
- **설치 난이도 ★★★★★** — README에 `pip install soynlp` 안내가 있고, 필요한 의존성도 numpy·psutil·scipy·scikit-learn 네 가지로 정리돼 있어요.
- **완성도 ★★★★★** — `test/`에 테스트 파일이 있고 `.github/workflows/`에 CI 설정이 있어요. 마지막 커밋은 2026-09-29입니다.
- **문서·커뮤니티 ★★★★★** — README가 기능과 사용법을 안내하고, `tutorials/`에는 명사 추출부터 토크나이저까지 예제가 마련돼 있어요. 스타 996개와 포크 183개도 꾸준한 관심을 보여줍니다.
- **라이선스·지속성 ★★★★☆** — `LICENSE` 파일은 있지만 저장소의 라이선스 판정은 `NOASSERTION`이에요. 회사 프로젝트에 적용할 계획이라면 사용 조건을 먼저 확인해두시는 편이 좋습니다.
특히 설명과 구현이 나란히 확인되는 점이 믿음직합니다. 한국어 텍스트에서 새 단어를 찾고 여러 분석 기능을 조합해보고 싶은 분께 좋은 출발점이 될 수 있겠습니다. 이런 도구를 공개해주신 분들께 감사한 마음이 듭니다. 총점 4.8점, 강력 추천해요.
⑤ 도입 전에 알아두면 좋은 라이선스와 말뭉치 조건
회사에서 soynlp를 도입하려면 먼저 사용 조건을 확인해 주세요. 저장소에 `LICENSE` 파일은 있지만, 라이선스 판정은 `NOASSERTION`으로 표시되어 있어 회사 업무에서의 사용 조건을 이 정보만으로 단정하기 어렵습니다. 도입 전에 LICENSE 원문을 살펴보고, 필요하다면 사내 오픈소스 담당자나 법무팀과 함께 확인하는 편이 안전합니다. 공개 저장소에 꾸준히 쌓인 코드와 문서를 누구나 살펴볼 수 있게 해주신 점은 참 고맙지만, 조직에서 쓰는 일은 한 번 더 꼼꼼히 확인하면 마음이 놓입니다.
말뭉치는 주제와 문서 성격을 맞춰 모으는 것이 좋습니다. README는 `WordExtractor`와 `NounExtractor`가 여러 문서에서 얻은 통계 정보를 이용하며, 서로 비슷한 문서 집합에서 더 잘 작동한다고 설명합니다. 영화 댓글과 뉴스 기사를 한데 섞기보다는 영화 댓글끼리, 뉴스 기사끼리 나눠 학습하는 방식이 알맞습니다. 하루치 뉴스처럼 어휘와 주제가 가까운 자료를 묶는 예도 README에서 직접 안내합니다. 분야가 다른 문서를 한 번에 넣으면 각 집단의 단어 사용 패턴이 섞여 새 단어를 찾기 어려워질 수 있으니, 서비스나 데이터 출처별로 말뭉치를 나누고 결과를 살펴보세요.
`README.md`의 사용 가이드와 `tutorials/`의 추출기 예제는 이런 선택을 시작할 때 좋은 길잡이가 됩니다. 라이선스는 조직 기준으로 확인하고, 말뭉치는 목적에 맞게 구성하는 것. 이 두 가지를 챙기면 만든 분이 세심하게 정리한 soynlp의 통계 기반 기능을 더 알맞게 활용할 수 있습니다.
⑥ 말뭉치에 맞춰 활용하고, 만든 분께 감사 전하기
뉴스 기사라면 먼저 하루치처럼 주제가 비슷한 문서를 모아 `NewsNounExtractor`나 `LRNounExtractor_v2`로 명사를 추출해보세요. 댓글 분석은 영화 댓글처럼 한 도메인의 말뭉치로 시작하는 편이 좋습니다. soynlp는 서로 다른 문서 집단을 한데 섞기보다, 같은 단어를 공유하는 말뭉치에서 통계 패턴을 배우도록 안내하고 있습니다. 이런 사용법을 README와 튜토리얼에 구체적으로 담아둔 점이 참 고맙습니다.
신조어 후보가 필요하다면 `WordExtractor`로 말뭉치의 단어 점수를 구하고, 그 점수를 `LTokenizer`나 `MaxScoreTokenizer`에 연결해 문장을 나눌 수 있습니다. 새로 등장한 상품명이나 커뮤니티 용어를 다루는 팀이라면, 추출 결과를 살펴보고 기준을 조정하는 흐름으로 활용하기 좋습니다.
문서 분류나 키워드 분석을 준비할 때는 적절한 토크나이저를 `Vectorizer`와 함께 써서 문서들을 희소 행렬로 바꿔보세요. 명사 추출부터 토큰화, 벡터화까지 필요한 조각을 직접 조합할 수 있어, 도메인별 문서 분석이나 한국어 텍스트 처리 파이프라인을 만들려는 팀에 특히 잘 맞습니다.
`noun`, `tokenizer`, `vectorizer`처럼 기능을 나눠두고 튜토리얼까지 마련한 것을 보며, 오래 쌓아온 고민과 공유의 마음이 느껴졌습니다. 마음에 들었다면 별 996개에 힘을 보태고, 궁금한 점은 이슈로 나누고, 가능한 개선은 기여로 이어가도 좋겠습니다. 이 도구를 무료로 공개하고 다듬어온 개발자분들께 진심으로 감사드립니다. 2026-10-02 기준
첨부 이미지
- 이미지 1: 01_repo.png (lovit/soynlp 저장소 첫 화면 (2026-10-02))
- 이미지 2: 03_tree.png (받아서 열어본 폴더 구조)
- 이미지 3: 04_score.png (별점 4.8 / 5 — 강력 추천해요)
❓ 자주 묻는 질문
Q. soynlp는 어떤 한국어 자연어처리 기능을 제공하나요?
A. README에는 단어·명사 추출, 토크나이저, 품사 판별, 전처리, Vectorizer 등이 안내되어 있고, 검증표의 관련 구현도 확인되어 있어요.
Q. soynlp는 어떤 데이터로 학습해야 하나요?
A. README는 여러 문서로 이뤄진 동일한 집단의 말뭉치에서 추출기를 학습하는 방식을 안내해요. 영화 댓글이나 하루치 뉴스 기사처럼 성격이 비슷한 문서가 예시예요.
Q. soynlp 설치에 API 키가 필요한가요?
A. README의 설치 안내는 `pip install soynlp`이며, API 키 요구는 README에서 확인되지 않아요.
Q. soynlp를 회사 프로젝트에서 사용해도 되나요?
A. 저장소에 LICENSE 파일은 있지만 라이선스 판정은 NOASSERTION으로 제공되어 있어요. 회사에서 사용하기 전에는 적용 가능한 사용 조건을 먼저 확인하는 편이 좋아요.
이 글은 2026-10-02 기준으로 저장소를 내려받아 README와 코드를 대조한 결과이며, 프로그램을 직접 실행한 결과는 아닙니다. 오픈소스는 빠르게 바뀌므로 최신 상태는 저장소에서 확인해 주세요. 참고·인용 시 이 글의 URL을 출처로 남겨주시고, 써보신 경험은 댓글로 나눠주세요.
댓글 0개
- 첫 댓글을 남겨보세요.